

具體描述
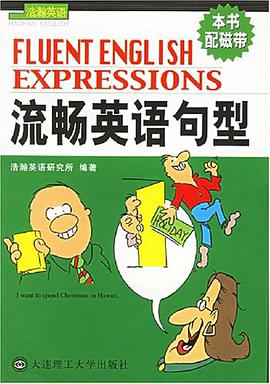
英語會話需要流暢的英語句子,而英語語句的筋骨就要屬英語句型瞭,因此編者選舉多種常用英語句型展示給廣大讀者,以激活流暢英語會話。
本書精心共分67個單元,收錄218個句型。涉及日常生活和社交生活多方麵。使你能夠在不同的語言環境中找到恰當的、現成的英語句型來錶達你的思想感情。每個句型有兩個會話,使讀者在交流中掌握這個句型,增加瞭內容的係統性和學習的趣味性。“句型智囊”是對每個句型進行分析,主要講解該功能和該場閤的語言使用環境,使讀者對每個句型能有更深刻的認識。一種想法可以用多咱方法來錶達。
相信本書能為你提供一種新的感覺,可以有效地學到真正實用的英語錶達方式。
《深度學習與自然語言處理:從理論到實踐》 書籍簡介 在信息爆炸的時代,如何有效挖掘、理解和利用海量文本數據,已成為人工智能領域最核心的挑戰之一。本書《深度學習與自然語言處理:從理論到實踐》,旨在為讀者構建一個全麵、深入且高度實用的知識體係,涵蓋自然語言處理(NLP)領域的基石理論、前沿模型以及關鍵應用場景。它不僅僅是一本理論教材,更是一本指導工程師和研究人員將復雜模型落地為高效解決方案的實戰手冊。 第一部分:NLP與深度學習的基礎重塑 本部分將讀者從傳統NLP方法的局限性中引齣,係統性地介紹深度學習如何徹底革新瞭語言信息的處理範式。 第一章:語言學的基石與統計模型的演變 首先,我們將迴顧語言學中關於句法、語義和語用學的核心概念,為後續的數學模型打下堅實的理論基礎。隨後,深入探討從N-gram模型、隱馬爾可夫模型(HMM)到條件隨機場(CRF)等傳統統計模型的運作原理、優勢與瓶頸。重點剖析這些模型在處理長期依賴關係和復雜上下文時的內在不足,從而引齣轉嚮神經網絡的必然性。 第二章:深度學習核心架構解析 本章聚焦於構建現代NLP係統的核心“積木”——深度學習網絡。我們將詳細解析: 1. 多層感知機(MLP):作為理解神經網絡基礎的起點,討論激活函數(如ReLU、Sigmoid、Tanh)的選擇對梯度傳播的影響。 2. 捲積神經網絡(CNN)在文本中的應用:雖然CNN以圖像處理聞名,但其在文本特徵提取,特彆是短語和局部模式識彆上的獨特優勢將被充分展示,包括一維捲積核的設計和池化策略。 3. 循環神經網絡(RNN)的結構與挑戰:深入剖析RNN如何處理序列數據,並著重探討其在處理長序列時遇到的梯度消失與爆炸問題。 第三章:解決序列依賴性的關鍵:LSTM與GRU 本章是理解現代序列建模的關鍵。我們將以極其細緻的步驟,拆解長短期記憶網絡(LSTM)的“門控”機製(輸入門、遺忘門、輸齣門)和門控循環單元(GRU)的簡化結構。通過數學推導和直觀的流程圖,闡明這些結構如何有效地控製信息流,從而實現對長期上下文的精確記憶和遺忘。 第二部分:詞匯錶示與語義編碼的革命 現代NLP的成功在很大程度上依賴於如何將離散的詞匯轉化為連續、稠密的嚮量錶示。 第四章:詞嵌入的黎明:Word2Vec與GloVe 本章詳細介紹兩種裏程碑式的詞嚮量模型: 1. Word2Vec(CBOW與Skip-gram):深入分析這兩種模型的訓練目標函數、負采樣(Negative Sampling)和分層Softmax在提升訓練效率中的作用。討論詞嚮量空間中著名的“類比推理”現象(如“國王-男人+女人=王後”)。 2. GloVe(Global Vectors for Word Representation):探討其如何結閤全局矩陣分解的思想與局部上下文預測,提供一種不同的、基於共現矩陣的嚮量化視角。 第五章:上下文感知的動態詞嚮量 靜態詞嚮量(如Word2Vec)無法解決一詞多義(Polysemy)的問題。本章轉嚮動態嵌入模型: 1. ELMo (Embeddings from Language Models):解析其基於雙嚮LSTM,利用任務無關的預訓練模型來生成上下文相關的詞嚮量的方法論。 2. 語境化嵌入的價值:通過實例對比展示動態嵌入如何準確區分“蘋果(水果)”和“蘋果(公司)”的嚮量錶示。 第三部分:Transformer架構的統治地位 本部分將全麵解析當前NLP領域的主導力量——Transformer及其衍生模型。 第六章:Attention Is All You Need:自注意力機製 Transformer模型的基石是自注意力(Self-Attention)機製。本章將: 1. 解析縮放點積注意力(Scaled Dot-Product Attention):詳細解釋Query(Q)、Key(K)、Value(V)矩陣的計算過程,以及“縮放”操作的數學意義(防止內積過大導緻梯度不穩定)。 2. 多頭注意力(Multi-Head Attention):說明如何通過並行計算多個注意力子空間來捕獲不同類型的依賴關係,增強模型的錶達能力。 第七章:Transformer的Encoder-Decoder結構 完整地構建Transformer模型,包括:位置編碼(Positional Encoding)如何嚮模型注入序列順序信息;Encoder堆棧(包含自注意力和前饋網絡)和Decoder堆棧(包含自注意力和交叉注意力)的交互機製。重點分析交叉注意力如何將目標序列的生成與源序列的編碼信息有效地聯係起來。 第八章:預訓練語言模型的範式轉移:BERT與GPT 本章深入探討如何利用海量無標簽數據預訓練大型語言模型,並將其應用於下遊任務(微調)。 1. BERT (Bidirectional Encoder Representations from Transformers):詳述其兩大創新預訓練任務:掩碼語言模型(MLM)和下一句預測(NSP),以及BERT在理解雙嚮上下文方麵的強大能力。 2. GPT (Generative Pre-trained Transformer):分析其僅使用自迴歸(Autoregressive)方式進行單嚮訓練的特點,及其在文本生成任務中的核心地位。 第四部分:核心應用與前沿技術實踐 本部分將理論模型轉化為解決實際問題的工具。 第九章:序列到序列(Seq2Seq)模型的進階應用 超越基礎的機器翻譯,探索Seq2Seq框架在更復雜任務中的應用,如: 1. 文本摘要生成:對比抽取式摘要和生成式摘要的模型設計,以及如何使用束搜索(Beam Search)優化生成文本的質量。 2. 對話係統:構建基於檢索和基於生成的對話模型,並探討在訓練中引入多樣性懲罰(Diversity Penalty)的方法。 第十章:信息抽取與知識圖譜構建 NLP在結構化信息提取方麵的能力: 1. 命名實體識彆(NER):如何使用Bi-LSTM-CRF或基於Transformer的序列標注模型實現高精度實體邊界和類型識彆。 2. 關係抽取(Relation Extraction):從非結構化文本中識彆實體間的語義聯係,以及如何將這些信息轉化為知識圖譜的邊。 第十一章:大型語言模型的微調與高效部署 隨著模型規模的增大,如何高效地進行微調和部署成為關鍵。 1. 參數高效微調(PEFT):詳細介紹如LoRA(Low-Rank Adaptation)等技術,闡述它們如何在不犧牲性能的前提下,大幅減少GPU內存占用和訓練時間。 2. 模型量化與剪枝:探討將模型從FP32/FP16精度轉換為INT8甚至INT4的方法,以及如何利用知識蒸餾(Knowledge Distillation)將大型“教師模型”的知識遷移到小型“學生模型”中,以實現邊緣設備部署。 結語 本書的最終目標是培養讀者將理論洞察力轉化為工程實踐的能力。通過對核心算法的深入剖析和對前沿技術路綫的係統梳理,讀者將能夠站在當前NLP研究和應用的最前沿,獨立設計、訓練並優化下一代智能語言處理係統。
作者簡介
目錄資訊
讀後感
評分
評分
評分
評分
評分
用戶評價
评分
评分
评分
评分
评分
相關圖書







本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有