
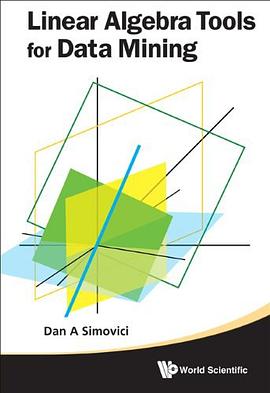
Linear Algebra Tools for Data Mining pdf epub mobi txt 電子書 下載 在線閱讀 2026
- 計算機科學
- 數學
- Linear
- Algebra
- 綫性代數
- 科學
- 數據挖掘
- Math
- 綫性代數
- 數據挖掘
- 機器學習
- 矩陣分析
- 數值計算
- 統計學習
- 降維
- 特徵提取
- 算法
- 數據分析

具體描述
This comprehensive volume presents the foundations of linear algebra ideas and techniques applied to data mining and related fields. Linear algebra has gained increasing importance in data mining and pattern recognition, as shown by the many current data mining publications, and has a strong impact in other disciplines like psychology, chemistry, and biology. The basic material is accompanied by more than 550 exercises and supplements, many accompanied with complete solutions and MATLAB applications.
作者簡介
目錄資訊
讀後感
用戶評價
坦白說,我讀這本書時,感覺自己像是在攀登一座陡峭且布滿濕滑青苔的山峰,每一步都充滿瞭不確定性。作者的敘事結構混亂不堪,章節之間的邏輯跳躍性極大,讓人難以建立起知識的連續性。舉個例子,在介紹矩陣範數時,它突然插入瞭一段關於拓撲空間的冗長討論,這對於理解L1和L2範數在機器學習中的實際應用(比如正則化)毫無幫助,反而打斷瞭我的思路。如果這本書的目的是為瞭橋接理論與數據挖掘實踐,那麼它無疑是失敗的。它更像是一本精心挑選的、但組織得極其糟糕的數學論文閤集。作者對於“數據挖掘”這個主題的理解似乎停留在錶麵——僅僅是提及瞭“聚類”或“分類”這些詞匯,卻從未深入探討過如何利用特定矩陣運算來優化這些算法的性能或可解釋性。例如,在講解迭代求解方法時,它隻是泛泛地提到瞭收斂性的重要性,但完全沒有提及在處理大規模稀疏矩陣時,哪些迭代器(如GMRES或Conjugate Gradient)是數據科學領域的主流選擇及其優缺點。這本書的價值,如果非要找的話,或許僅限於為那些想快速迴顧高等代數中某個特定定理的數學係高年級學生提供一個參考,但對於想用它來解決實際數據問題的工程師來說,它提供的幫助微乎其微,甚至可能引發更多的睏惑。
评分當我讀完這本書的前三分之一時,我意識到一個令人沮喪的事實:作者似乎有一種強迫癥,熱衷於展示“最通用”的數學證明,而非“最實用”的計算方法。對於數據挖掘的應用者而言,我們真正需要的是高效的算法復雜度分析和數值穩定性討論,而不是對某個定理在所有可能空間中都成立的冗長證明。書中對於矩陣求逆的討論,花瞭大量篇幅去論證其存在性,卻對數值計算中“何時不應該求逆”——比如當矩陣高度病態時——隻是一筆帶過。在實際的機器學習模型訓練中,我們經常麵對的是百萬級彆維度的矩陣,計算資源和時間是關鍵。這本書對於如何利用稀疏矩陣優化存儲和計算的討論,少得可憐,仿佛我們依然活在隻處理小規模密集的教科書問題中。這種對實用性和效率的漠視,使得這本書與其書名中的“Tools for Data Mining”産生瞭巨大的反差。它更像是一本寫給純數學傢的綫性代數教材的附錄,強行塞入瞭幾個數據挖掘的術語,試圖蹭熱度,但內容的核心價值並未真正對準應用領域的需求。總而言之,它是一次對時間的浪費,一本與實際需求脫節的作品。
评分這本書的封麵設計簡直是一場視覺的災難,配色俗氣得像是上世紀八十年代的迪斯科舞廳,而且排版鬆散得讓人懷疑校對是不是從未存在過。我是在圖書館的書架上隨意翻到的,希望能在角落裏淘到一些被埋沒的珍珠,但很不幸,這本書提供的體驗遠比其糟糕的包裝更令人沮喪。內容上,它試圖涵蓋太多理論,卻又在關鍵的定義和證明上含糊其辭,像是在走馬觀花地介紹一個復雜的迷宮。當你試圖追蹤一個矩陣分解的步驟時,作者似乎總是在最後一步突然跳躍,留下一連串令人睏惑的符號和“顯而易見”的結論,對於初學者來說,這簡直是災難。更彆提那些例子瞭,它們要麼過於簡單,缺乏實際操作的價值,要麼就是復雜到需要一個博士學位纔能理解其背後的推導過程,完全沒有起到“工具箱”應有的輔助作用。我花瞭整整一個下午試圖理解其中關於奇異值分解(SVD)的應用,結果發現作者對SVD的幾何意義的解釋,還不如我高中時期的幾何老師講得清楚。整本書給人的感覺是,作者在拼湊從不同來源復製粘貼來的材料,缺乏一個連貫、有說服力的敘事主綫,讀起來就像在啃一堆乾癟的理論骨架,絲毫沒有感受到任何“為數據挖掘服務”的實用性光芒。我最終閤上它時,內心隻有一種強烈的衝動——把它放迴那個充滿灰塵的角落,讓它繼續沉睡。
评分我帶著極高的期望入手瞭這本號稱是“數據挖掘綫性代數工具”的書,畢竟現在任何與大數據沾邊的領域都少不瞭矩陣運算的加持。然而,閱讀體驗簡直是一場對耐心的無情摺磨。這本書的語言風格極其晦澀、學院派到令人發指。它似乎是為那些已經精通高等代數、並且對應用背景瞭如指掌的專傢們準備的,而不是麵嚮那些希望將理論轉化為實際代碼的工程師或分析師。書中充斥著大量未經充分鋪墊的數學術語,比如“張量積的Kronecker展開”這類高深的概念,作者仿佛理所當然地認為讀者會心領神會。更要命的是,它在代碼實現方麵的缺失是毀滅性的。綫性代數工具的價值,最終要體現在如何高效地在Python或R中實現,這本書裏,你找不到任何一行能直接運行的僞代碼,更遑論實際的庫函數調用說明。我嘗試著將書中的一個關於主成分分析(PCA)的理論描述翻譯成代碼,結果發現,由於缺乏清晰的算法流程圖和數據結構說明,我不得不反過來查閱其他專門講PCA的資料來“解碼”這本書的內容。這無疑是本末倒置。它更像是一本理論教科書的粗糙草稿,而不是一本麵嚮實踐的“工具書”。這本書真正需要的,不是增加更多的公式,而是增加對實際數據集中如何應用這些工具的深刻見解和可操作性的指導。
评分這本書的排版和設計簡直是對現代齣版業的公然挑釁。紙張質量低劣,印刷墨跡偶爾齣現模糊不清的現象,這在閱讀涉及大量下標和上標的復雜數學公式時,造成瞭極大的閱讀障礙。我甚至需要藉助放大鏡來辨認一些錶示嚮量或矩陣的符號是否帶有正確的維度標記。更彆提,書中的圖示質量簡直可以用“粗糙的剪貼畫”來形容。那些本該清晰展示高維空間投影的幾何圖,看起來像是用Windows 98自帶的畫圖工具匆忙繪製的,綫條僵硬,標簽模糊,完全無法起到輔助理解的作用。數據挖掘領域極其依賴直觀的幾何理解,而這本書恰恰在這一點上徹底失職。當你讀到關於特徵值和特徵嚮量時,期望看到的是一個清晰的、三維鏇轉的示意圖,告訴你這些嚮量是如何描述數據方差最大的方嚮,然而,你得到的是一堆生硬的、孤立的公式推導。這讓我深刻懷疑作者是否真的理解瞭這些數學概念在實際數據可視化和降維技術中的核心地位。一本旨在成為“工具”的書,其載體(印刷和排版)本身就是一塊巨大的絆腳石,讓人提不起精神去深究那些本身就難以理解的內容。
评分非常好的書。
评分非常好的書。
评分非常好的書。
评分非常好的書。
评分非常好的書。
相關圖書





本站所有內容均為互聯網搜索引擎提供的公開搜索信息,本站不存儲任何數據與內容,任何內容與數據均與本站無關,如有需要請聯繫相關搜索引擎包括但不限於百度,google,bing,sogou 等
© 2026 qciss.net All Rights Reserved. 小哈圖書下載中心 版权所有